图片 OCR
上传 PNG、JPG、JPEG 或 WEBP 图片,MindLM 先用 OCR 识别图片中的文字,再整理成结构化思维导图。本文说明支持的格式与大小限制、使用步骤、提高识别率的技巧、计费方式以及常见问题。
最后更新 ·
上传截图或照片,系统先识别图片里的文字,再生成导图。适合处理扫描件、幻灯片截图、白板照片,以及别的工具导出的导图图片。
适用场景
- 扫描版 PDF 的页面截图
- 课件、幻灯片、白板的照片
- 其他思维导图工具导出的图片(放射式或树状布局识别效果最好)
- 书页、讲义的清晰照片
支持的格式与大小
| 格式 | 单文件上限 | 可用套餐 |
|---|---|---|
| PNG、JPG、JPEG、WEBP | 10MB | 所有套餐 |
使用步骤
- 在左侧栏选「图像文件」,拖入或选择图片。
- 页面显示「预估消耗 1 积分」,需要的话调整输出语言、模型和详细度。
- 点击生成,通常 1 分钟左右完成,自动进入编辑器。
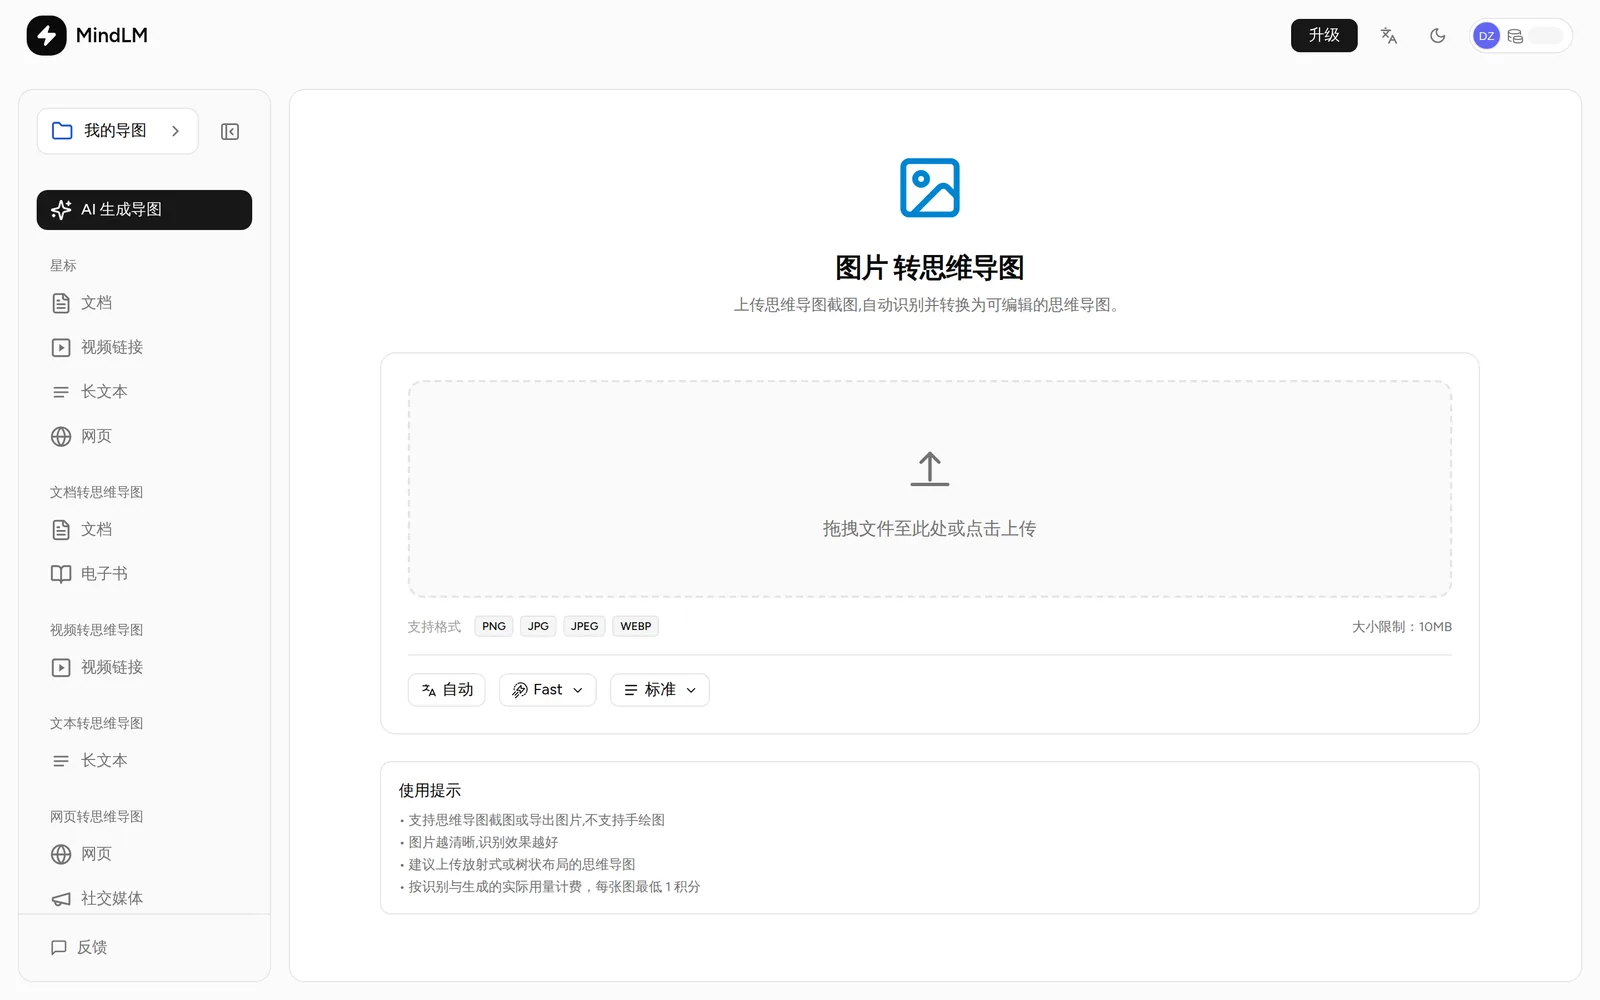
提高识别效果
- 图片越清晰越好:正对拍摄、光线均匀、避免反光。
- 把图片裁剪到文字区域,去掉无关背景。
- 不支持手绘草图和艺术字;识别语言以简体中文和英文为主。
- 一次一张图。多页内容请分别上传,或先合成一张清晰的长图。
计费
按识别和生成的实际用量结算,每张图最低 1 积分。上传前会先预扣 1 积分,完成后多退少补。
常见问题
识别出来的文字有错怎么办?
生成后在编辑器进入编辑模式,双击节点直接修正。错误较多时换一张更清晰的图重新生成。
能上传整个 PDF 的截图吗?
可以,但每次只能一张图。页数多的话,优先用 文档上传;只有扫描件才需要走 OCR。
更多问题见 帮助中心。