计算机思维导图
把论文、课程视频或课堂笔记整理成概念、原理和它们之间的关系。
MindLM 免费、无需注册:粘贴会议记录、笔记或文章,直接生成可编辑的思维导图。
不注册可试 3 次,每次最多 5,000 字,和网页、文件上传共用
免费账号:10 积分 + 每天 1 积分,无需信用卡;每张导图最多 10 万字符
Pro 每张 30 万字符,Max 60 万字符
真实示例:计算机思维导图
下面的导图由 MindLM 用线上同一套流程生成,未经人工修改。可以展开节点,也可以在编辑器里打开一份自己的副本。
你添加的是
1706.03762v7.pdf
PDF · 15 页
15 页 · 约 6,100 词 生成 84 个节点
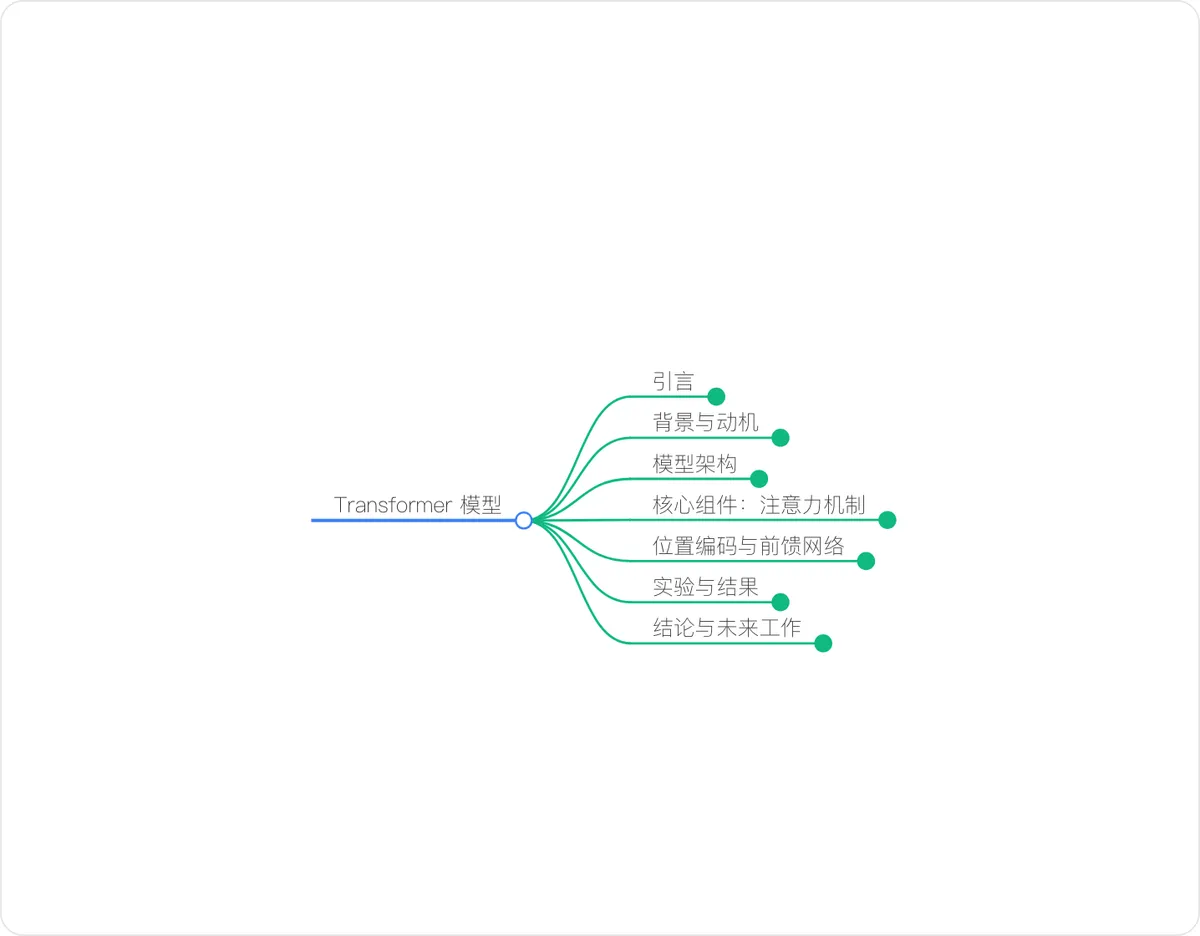 正在加载可交互的导图…
拖动可平移,点击节点可折叠。
这张计算机思维导图的全部节点文字(84 个节点)
Transformer 模型
- 引言
- 现状:基于 RNN/CNN 的序列模型
- RNN/CNN 的局限性:顺序计算,难以并行
- 核心创新:Transformer 模型,仅基于注意力机制
- 优势:并行性、训练速度、翻译质量
- 背景与动机
- 现有序列模型:RNN (LSTM, GRU), CNN (Extended Neural GPU, ByteNet, ConvS2S)
- 现有模型局限:
- RNN: 顺序计算,难以并行,长距离依赖学习困难 (O(n) 顺序操作)
- CNN: 依赖于卷积核大小,长距离依赖学习路径长 (O(logk n) 或 O(n/k))
- Transformer 的优势:
- 常数顺序操作 (O(1))
- 路径长度短 (O(1))
- 理论上计算复杂度 (O(n²·d))
- Self-Attention (自注意力): 关联同一序列内的不同位置
- 动机:
- 计算复杂度
- 可并行性
- 学习长距离依赖的能力
- 模型架构
- 整体结构:Encoder-Decoder
- Encoder:
- N 层相同层堆叠 (N=6)
- 每层包含:
- 多头自注意力机制
- 位置wise 前馈网络
- 子层连接:残差连接 + Layer Normalization
- Decoder:
- N 层相同层堆叠 (N=6)
- 每层包含:
- masked 多头自注意力机制 (防止 attending to subsequent positions)
- Encoder-Decoder 注意力机制
- 位置wise 前馈网络
- 子层连接:残差连接 + Layer Normalization
- 核心组件:注意力机制
- Attention Function: Query, Key, Value -> Output
- Scaled Dot-Product Attention:
- 计算方式: softmax(Q * K^T / sqrt(dk)) * V
- 缩放因子 sqrt(dk) 的作用:避免 softmax 梯度过小
- 优点:高效,易于实现
- Multi-Head Attention:
- 机制:将 Q, K, V 线性投影 h 次,并行执行 Attention,然后拼接并再次投影
- 作用:允许模型同时关注来自不同表示子空间的信息
- 参数设置:h=8, dk=dv=dmodel/h=64
- Transformer 中的应用:
- Encoder-Decoder Attention: Decoder query, Encoder memory K/V
- Encoder Self-Attention: Q, K, V 来自 Encoder 前一层输出
- Decoder Self-Attention: Q, K, V 来自 Decoder 前一层输出 (masked)
- 位置编码与前馈网络
- Position-wise Feed-Forward Networks:
- 结构:两个线性变换 + ReLU 激活
- 应用:每个位置独立应用,参数相同
- 维度:dmodel -> dff -> dmodel (dff=2048)
- Embeddings and Softmax:
- 输入/输出:Token -> 词嵌入 (dmodel)
- 共享权重:embedding 层与 softmax 层共享权重矩阵
- 缩放:embedding 乘以 sqrt(dmodel)
- Positional Encoding:
- 目的:注入序列位置信息(由于无 RNN/CNN)
- 类型:固定(正弦/余弦)或学习
- 使用:加到输入 embedding 上
- 公式:P E(pos,2i) = sin(pos/10000^(2i/dmodel)), P E(pos,2i+1) = cos(pos/10000^(2i/dmodel))
- 优点:易于模型学习相对位置关系,可外插更长序列
- Position-wise Feed-Forward Networks:
- 实验与结果
- 机器翻译任务 (WMT 2014 EN-DE, EN-FR):
- Transformer (big) 达到 SOTA BLEU 分数 (28.4 EN-DE, 41.8 EN-FR)
- 训练成本显著降低 (相比其他模型)
- 模型变体分析 (Table 3):
- Attention heads/dimensions: single-head 略差,过多 heads 质量下降
- dk 减小 hurts quality
- 模型规模越大越好 (rows C, D)
- Dropout 非常有效 (rows D)
- Positional encoding 类型影响不大 (row E)
- 其他任务:English Constituency Parsing
- 在小数据集和小数据增广场景下表现优异
- 泛化能力强
- 机器翻译任务 (WMT 2014 EN-DE, EN-FR):
- 结论与未来工作
- 核心贡献:Transformer 模型,完全基于注意力,抛弃 RNN/CNN
- 优势总结:并行性、训练速度、翻译质量 SOTA
- 未来工作:
- 应用于其他模态 (图像, 音频, 视频)
- 探索局部/受限注意力机制
- 减少生成过程的顺序性
你添加的是
But what is a neural network? | Deep learning chapter 1
YouTube · 18:40Pro
18:40 · 约 3,400 词 生成 87 个节点
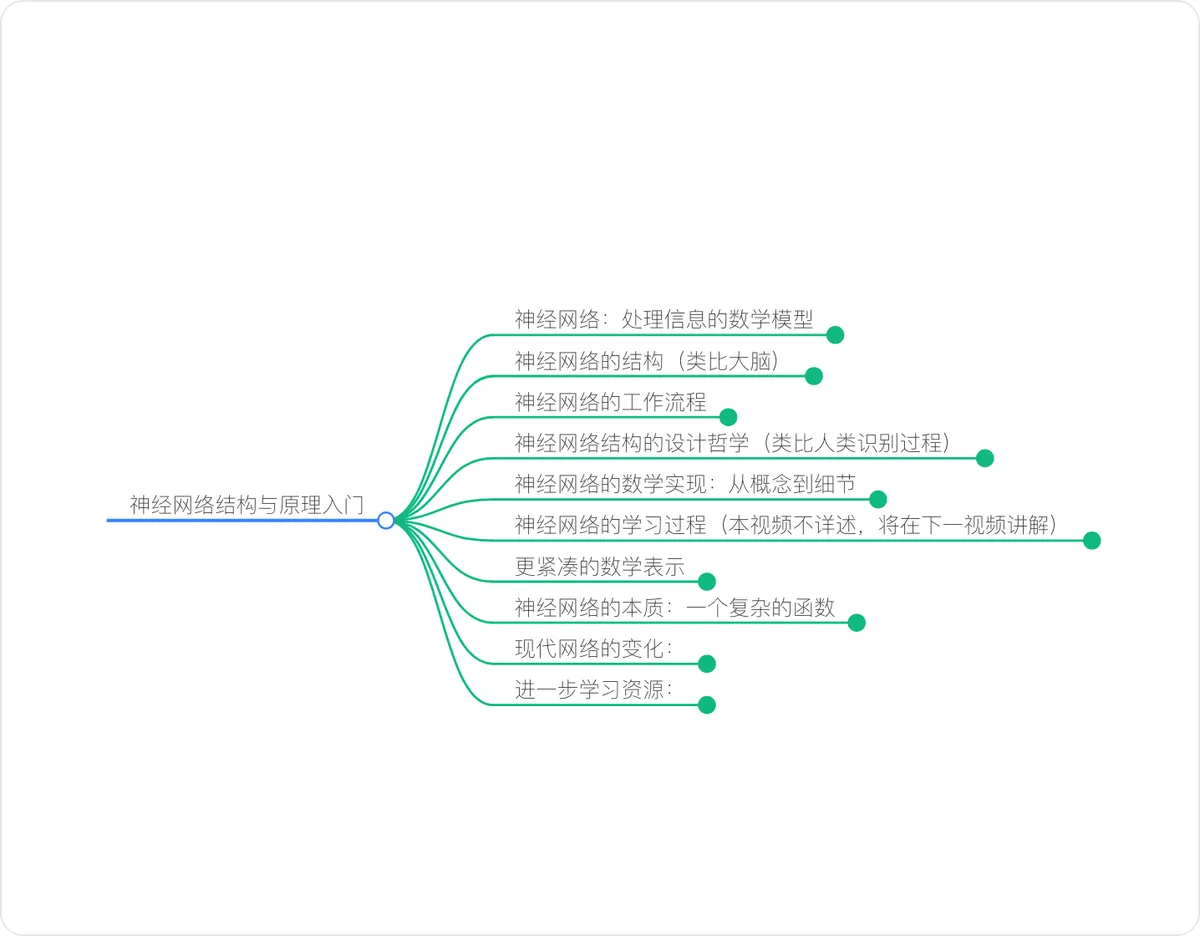 正在加载可交互的导图…
拖动可平移,点击节点可折叠。
这张计算机思维导图的全部节点文字(87 个节点)
神经网络结构与原理入门
- 神经网络:处理信息的数学模型
- 核心功能:识别手写数字
- 输入:28x28像素图像 (784个像素)
- 输出:0-9的数字预测
- 学习难度对比
- 人类:识别数字非常容易
- 计算机(编程):识别数字非常困难
- 神经网络的意义
- 机器学习和人工智能的重要组成部分
- 解释神经网络的结构和工作原理
- 核心功能:识别手写数字
- 神经网络的结构(类比大脑)
- 组成单元:神经元
- 定义:一个存储数字(0-1之间)的单元
- 激活值:神经元中存储的数字
- 网络层级
- 输入层:对应图像的每个像素
- 神经元数量:784个
- 激活值:像素的灰度值 (0黑 - 1白)
- 输出层:对应0-9的十个数字
- 神经元数量:10个
- 激活值:模型对该数字的置信度 (0-1)
- 隐藏层:连接输入层和输出层
- 作用:处理中间的信息
- 示例:本网络有两个隐藏层,每个16个神经元(数量可调整)
- 输入层:对应图像的每个像素
- 层间连接
- 激活值传递:前一层神经元的激活值决定下一层神经元的激活值
- 类比:生物神经网络中,一部分神经元激活会引发其他神经元的激活
- 组成单元:神经元
- 神经网络的工作流程
- 已训练网络:输入图像 -> 特定激活模式 -> 逐层传递 -> 输出层激活模式 -> 预测结果(最亮的神经元)
- 神经网络结构的设计哲学(类比人类识别过程)
- 人类识别:将整体分解为组件
- 数字组件示例:圆形、直线等
- 神经网络的期望
- 隐藏层神经元:可能对应图像的子组件(如边缘、形状)
- 第二层(隐藏层):可能识别边缘
- 第三层(隐藏层):可能识别更复杂的模式(如圆形)
- 最终层:根据子组件组合识别数字
- 隐藏层神经元:可能对应图像的子组件(如边缘、形状)
- 分层抽象的普适性
- 图像识别
- 语音识别(声音->音素->音节->单词->短语)
- 人类识别:将整体分解为组件
- 神经网络的数学实现:从概念到细节
- 激活值的计算:如何从一层到下一层
- 核心:加权求和 + 激活函数
- 加权求和:
- 为连接分配权重(weights):表示连接的重要性
- 权重可以可视化为像素网格(绿正红负)
- 目的:突出感兴趣的区域或模式
- 偏置(bias):
- 作用:调整加权求和的结果,引入“阈值”
- 目的:控制神经元激活的难易程度
- 激活函数(Activation Function):
- 作用:将加权求和+偏置的结果“压缩”到特定范围(如0-1)
- Sigmoid函数:
- 经典激活函数
- 将任意实数映射到0-1之间
- 极负输入接近0,极正输入接近1
- ReLU函数 (Rectified Linear Unit):
- 现代常用激活函数
- max(0, a),其中a是加权求和+偏置
- 优点:训练更容易,尤其对于深度网络
- 权重和偏置的数量:
- 网络的“旋钮”和“调谐器”
- 示例:一个16神经元的隐藏层,与784个输入神经元连接,需要 784*16 个权重 + 16 个偏置
- 总计:一个网络可能包含数千甚至数百万的权重和偏置
- 激活值的计算:如何从一层到下一层
- 神经网络的学习过程(本视频不详述,将在下一视频讲解)
- 目标:调整权重和偏置,使网络能解决特定问题
- 手动调整的思考:理解权重和偏置的含义,有助于调试和改进网络
- 更紧凑的数学表示
- 向量和矩阵:
- 激活值:表示为列向量
- 权重:表示为矩阵 (每行对应连接到下一层的一个神经元)
- 矩阵向量乘法:计算加权求和
- 偏置:表示为向量,与矩阵向量乘法结果相加
- 激活函数:应用于结果向量的每个元素
- 优点:简洁、高效(便于计算机优化)
- 向量和矩阵:
- 神经网络的本质:一个复杂的函数
- 输入:784个数字(像素值)
- 输出:10个数字(数字置信度)
- 参数:13,000+ 的权重和偏置
- 计算过程:多次矩阵向量乘法和激活函数应用
- 现代网络的变化:
- Sigmoid函数不再是首选,ReLU更常用
- 训练难度:Sigmoid有时难以训练,ReLU效果更好
- 进一步学习资源:
- 推荐相关视频系列(线性代数)
- 提及可下载代码进行实践
计算机思维导图该怎么分支
整理这类导图的一种好思路,在编辑器里调整时可以照着检查。
要解决的问题
之前什么慢、什么错、什么做不到。大多数计算机概念,要放在它解决的限制旁边才看得懂。
核心思想
用一两个节点讲清机制,比如「用注意力代替循环」「把键哈希成下标」。
工作原理
每个组件或步骤一个子分支,公式、伪代码放在叶子节点。
复杂度与结果
时间空间复杂度、基准测试,或论文报告的数字——证明这个想法有效的证据。
取舍与应用
什么时候不该用、代价是什么、在真实系统里用在哪。
什么时候用
读书会前啃一篇论文
上传 PDF,先拿到问题、方法、实验、局限几个分支,再回到真正重要的章节精读。
把课程视频变成复习笔记
把录播课或 YouTube 讲解视频转成导图,再在没听懂的分支上补自己的笔记。
对比两种方案
粘贴两种数据结构或协议的资料,在面试或方案评审前把取舍并排看清楚。
用 AI 生成思维导图的三个步骤
粘贴文本或链接
文章、笔记、网页 URL 或小型 PDF 都可以,不用注册。登录后还能上传电子书和更大的文件。
1–3 分钟拿到导图
AI 通读内容,保留原有结构,整理成一条条可以逐个展开的分支。
浏览、编辑、导出
折叠展开分支、改节点文字,然后导出 PNG、Markdown 或 XMind,在哪里都能用。
常见问题
能处理公式和代码吗?
公式和短代码片段会以文字形式保留在对应节点上。大段代码会被概括而不是逐行照抄——导图适合呈现结构,不适合放源码。
能整理一整章教材吗?
可以。登录后上传 PDF 或 EPUB,章节标题会成为一级分支。本页的免费试用支持粘贴 5000 字以内的文本。
支持哪些语言?
原文可以是英文、中文等主流语言,导图语言可以单独选择——很适合用中文读英文论文。