Attention Is All You Need(Transformer 论文) 思维导图
PDF · 15 页 · 84 个节点
你添加的是
1706.03762v7.pdf
PDF · 15 页
15 页 · 约 6,100 词 生成 84 个节点
原文摘录: Attention Is All You Need
Abstract
The dominant sequence transduction models are based on complex recurrent or convolutional neural networks that include an encoder and a decoder. The best performing models also connect the encoder and decoder through an attention mechanism. We propose a new simple network architecture, the Transformer, based solely on attention mechanisms, dispensing with recurrence and convolutions entirely.
可交互导图
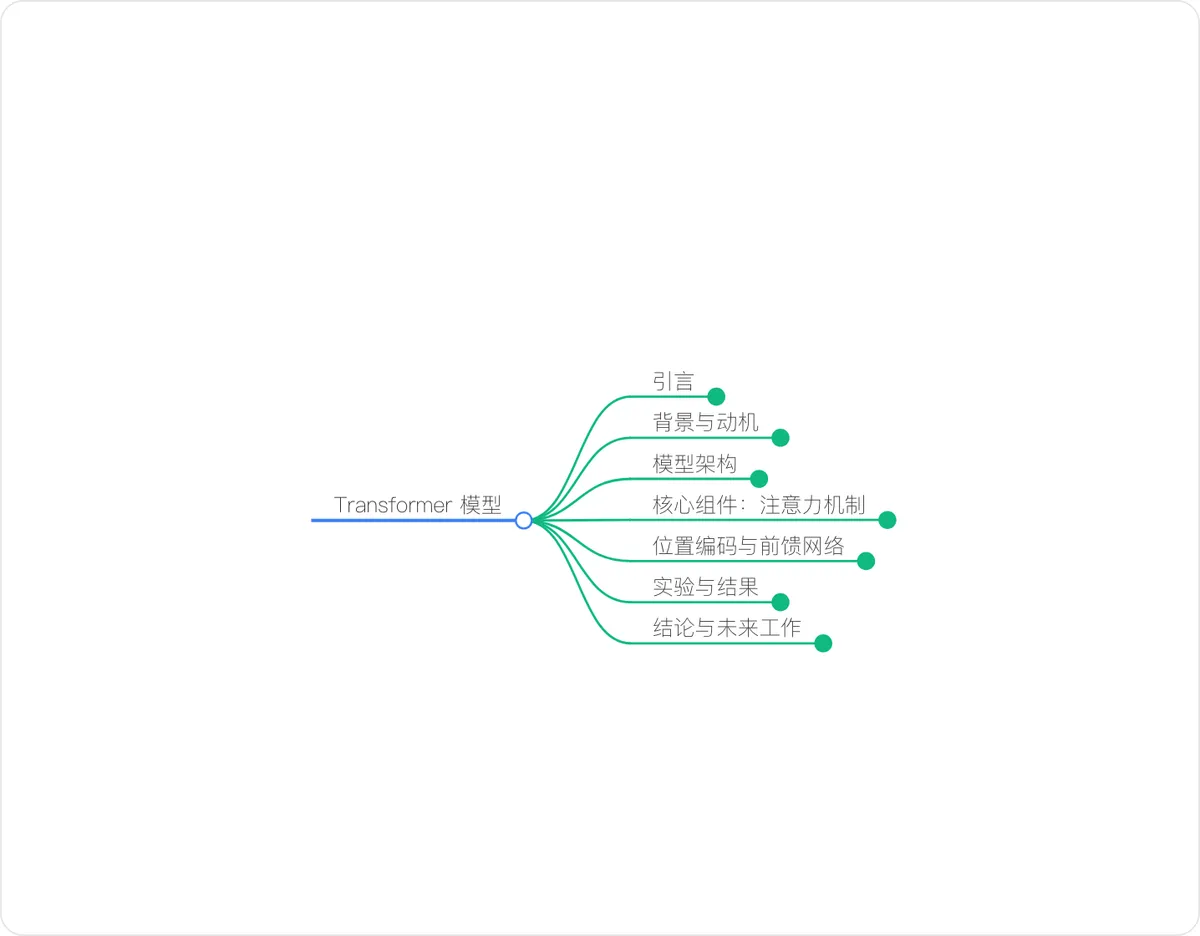 正在加载可交互的导图…
拖动可平移,点击节点可折叠。
在编辑器中打开需免费账号
用你自己的文件试试免注册,4 MB 以内
内容摘要
《Attention Is All You Need》(Vaswani 等,2017)提出了 Transformer:一种完全基于注意力机制、不用循环也不用卷积的序列转换模型。编码器和解码器各由 6 层相同的层堆叠而成,每层包含多头自注意力和逐位置前馈网络,子层之间用残差连接和层归一化。模型本身不感知顺序,因此在输入嵌入上叠加正弦位置编码。自注意力让任意两个位置之间的路径长度为常数,长距离依赖更容易学习,并行度也远高于 RNN。在 WMT 2014 上,Transformer 英德翻译达到 28.4 BLEU、英法达到 41.8 BLEU,以更少的训练成本超过了此前的最佳结果,并能推广到英语成分句法分析任务。
要点
- Transformer 只用注意力机制替代循环和卷积,编码器与解码器各 6 层相同结构。
- 缩放点积注意力 softmax(QKᵀ/√dk)V 与多头注意力让模型并行关注不同的表示子空间。
- 注意力本身不感知顺序,用正弦位置编码把词序信息注入输入。
- 自注意力的顺序操作是 O(1)、位置间路径长度也是 O(1),RNN 则是 O(n)。
- WMT 2014 英德 28.4 BLEU、英法 41.8 BLEU,8 块 P100 上 3.5 天训练完成。
全部 84 个节点
以大纲形式展示完整导图。
Transformer 模型
- 引言
- 现状:基于 RNN/CNN 的序列模型
- RNN/CNN 的局限性:顺序计算,难以并行
- 核心创新:Transformer 模型,仅基于注意力机制
- 优势:并行性、训练速度、翻译质量
- 背景与动机
- 现有序列模型:RNN (LSTM, GRU), CNN (Extended Neural GPU, ByteNet, ConvS2S)
- 现有模型局限:
- RNN: 顺序计算,难以并行,长距离依赖学习困难 (O(n) 顺序操作)
- CNN: 依赖于卷积核大小,长距离依赖学习路径长 (O(logk n) 或 O(n/k))
- Transformer 的优势:
- 常数顺序操作 (O(1))
- 路径长度短 (O(1))
- 理论上计算复杂度 (O(n²·d))
- Self-Attention (自注意力): 关联同一序列内的不同位置
- 动机:
- 计算复杂度
- 可并行性
- 学习长距离依赖的能力
- 模型架构
- 整体结构:Encoder-Decoder
- Encoder:
- N 层相同层堆叠 (N=6)
- 每层包含:
- 多头自注意力机制
- 位置wise 前馈网络
- 子层连接:残差连接 + Layer Normalization
- Decoder:
- N 层相同层堆叠 (N=6)
- 每层包含:
- masked 多头自注意力机制 (防止 attending to subsequent positions)
- Encoder-Decoder 注意力机制
- 位置wise 前馈网络
- 子层连接:残差连接 + Layer Normalization
- 核心组件:注意力机制
- Attention Function: Query, Key, Value -> Output
- Scaled Dot-Product Attention:
- 计算方式: softmax(Q * K^T / sqrt(dk)) * V
- 缩放因子 sqrt(dk) 的作用:避免 softmax 梯度过小
- 优点:高效,易于实现
- Multi-Head Attention:
- 机制:将 Q, K, V 线性投影 h 次,并行执行 Attention,然后拼接并再次投影
- 作用:允许模型同时关注来自不同表示子空间的信息
- 参数设置:h=8, dk=dv=dmodel/h=64
- Transformer 中的应用:
- Encoder-Decoder Attention: Decoder query, Encoder memory K/V
- Encoder Self-Attention: Q, K, V 来自 Encoder 前一层输出
- Decoder Self-Attention: Q, K, V 来自 Decoder 前一层输出 (masked)
- 位置编码与前馈网络
- Position-wise Feed-Forward Networks:
- 结构:两个线性变换 + ReLU 激活
- 应用:每个位置独立应用,参数相同
- 维度:dmodel -> dff -> dmodel (dff=2048)
- Embeddings and Softmax:
- 输入/输出:Token -> 词嵌入 (dmodel)
- 共享权重:embedding 层与 softmax 层共享权重矩阵
- 缩放:embedding 乘以 sqrt(dmodel)
- Positional Encoding:
- 目的:注入序列位置信息(由于无 RNN/CNN)
- 类型:固定(正弦/余弦)或学习
- 使用:加到输入 embedding 上
- 公式:P E(pos,2i) = sin(pos/10000^(2i/dmodel)), P E(pos,2i+1) = cos(pos/10000^(2i/dmodel))
- 优点:易于模型学习相对位置关系,可外插更长序列
- Position-wise Feed-Forward Networks:
- 实验与结果
- 机器翻译任务 (WMT 2014 EN-DE, EN-FR):
- Transformer (big) 达到 SOTA BLEU 分数 (28.4 EN-DE, 41.8 EN-FR)
- 训练成本显著降低 (相比其他模型)
- 模型变体分析 (Table 3):
- Attention heads/dimensions: single-head 略差,过多 heads 质量下降
- dk 减小 hurts quality
- 模型规模越大越好 (rows C, D)
- Dropout 非常有效 (rows D)
- Positional encoding 类型影响不大 (row E)
- 其他任务:English Constituency Parsing
- 在小数据集和小数据增广场景下表现优异
- 泛化能力强
- 机器翻译任务 (WMT 2014 EN-DE, EN-FR):
- 结论与未来工作
- 核心贡献:Transformer 模型,完全基于注意力,抛弃 RNN/CNN
- 优势总结:并行性、训练速度、翻译质量 SOTA
- 未来工作:
- 应用于其他模态 (图像, 音频, 视频)
- 探索局部/受限注意力机制
- 减少生成过程的顺序性